Crawl Budget Website Game Menghindari Ribuan URL yang Tidak Perlu Dirayapi
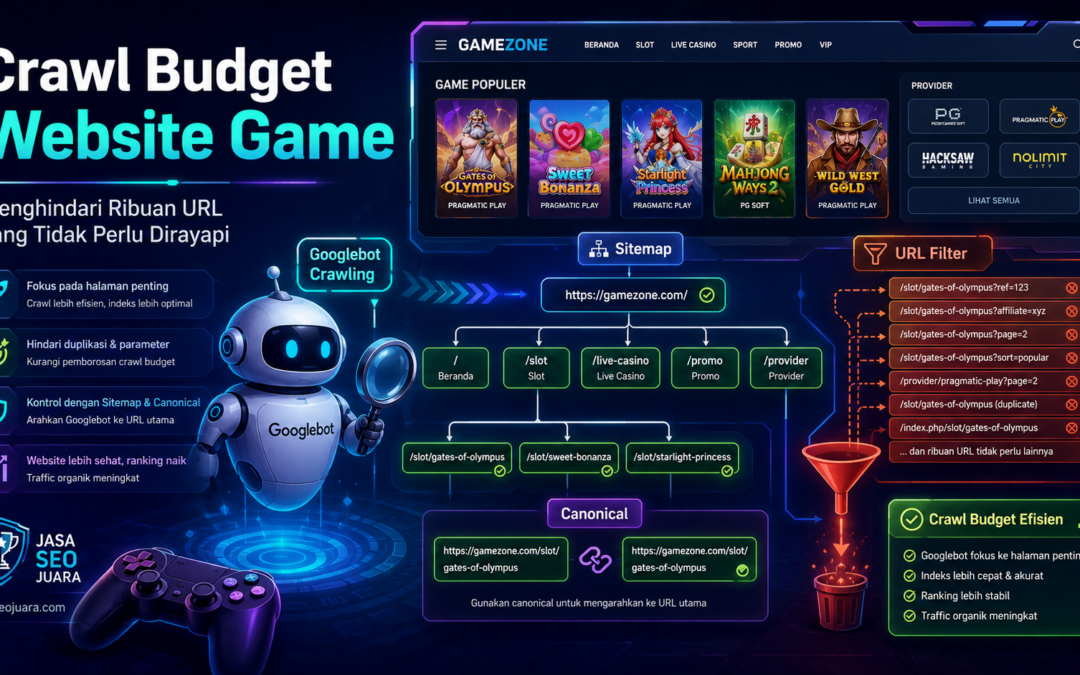
Crawl budget SEO pada website game perlu dikelola agar Googlebot lebih banyak mengakses URL yang bernilai, bukan terjebak pada filter, parameter, halaman duplikat, pencarian internal, atau URL lama. Crawl efficiency yang baik membantu Google menemukan dan memperbarui halaman penting secara lebih efisien.
Website game sering mempunyai jumlah URL yang jauh lebih besar daripada jumlah halaman yang benar-benar dibutuhkan pengguna maupun mesin pencari.
Kategori game, provider, filter, pagination, tracking parameter, halaman pencarian, versi AMP, dan berbagai variasi URL dapat membuat inventaris situs berkembang dengan cepat.
Google mendefinisikan crawl budget sebagai kumpulan URL yang dapat dan ingin dirayapi Google. Besarnya dipengaruhi terutama oleh crawl capacity dan crawl demand.
Karena itu, optimasi crawl budget bukan tentang membuat Googlebot mengunjungi website sebanyak mungkin. Fokusnya adalah memastikan kapasitas crawling digunakan pada konten yang memang layak ditemukan, diproses, dan diperbarui.
Apa yang Dimaksud Crawl Budget SEO pada Website Game?
Crawl budget SEO adalah jumlah dan prioritas URL yang dapat serta ingin dirayapi Google dalam sebuah website pada periode tertentu.
Google menentukan aktivitas crawling dengan mempertimbangkan kemampuan server menerima permintaan serta kebutuhan sistem Google untuk mengunjungi kembali suatu URL.
Artinya, mempunyai ratusan ribu URL tidak berarti seluruh URL tersebut akan mendapatkan frekuensi crawling yang sama.
Halaman populer, unik, sering diperbarui, dan mempunyai nilai bagi pengguna biasanya mempunyai alasan lebih kuat untuk dikunjungi kembali dibanding URL duplikat atau halaman tanpa fungsi pencarian yang jelas.
Pada website game, pengelolaan crawl budget menjadi penting ketika sistem menghasilkan banyak URL melalui kategori, provider, filter, sorting, parameter, dan variasi navigasi.
Jika variasi tersebut tidak dikendalikan, Googlebot dapat menghabiskan sebagian aktivitas crawling untuk URL yang menampilkan informasi sama atau sangat mirip.
Mengapa Crawl Budget Tidak Sama dengan Faktor Ranking?
Crawl budget membantu proses discovery dan crawling, tetapi frekuensi Googlebot mengunjungi halaman bukan faktor yang secara otomatis meningkatkan ranking.
Halaman tetap membutuhkan konten relevan, search intent yang tepat, struktur internal linking yang baik, kualitas informasi, authority, dan pengalaman pengguna.
Crawling hanyalah salah satu tahap sebelum halaman dapat dipertimbangkan dalam proses indexing dan ranking.
Dengan kata lain, meningkatkan jumlah crawl tanpa meningkatkan kualitas halaman tidak memberikan jaminan posisi yang lebih tinggi.
Optimasi crawl budget lebih tepat dipandang sebagai bagian dari technical SEO yang membantu mesin pencari mengalokasikan resource secara lebih efisien.
Mengapa Website Game Bisa Menghasilkan Ribuan URL yang Tidak Perlu Dirayapi?
Website game dapat menghasilkan ribuan URL akibat kombinasi filter, sorting, pagination, query parameter, provider, pencarian internal, tracking, dan sistem navigasi lainnya.
Salah satu penyebab paling umum adalah faceted navigation, yaitu sistem yang memungkinkan pengguna memfilter daftar berdasarkan beberapa atribut sekaligus.
Bayangkan sebuah katalog mempunyai filter provider, kategori, perangkat, volatilitas, dan urutan game.
Jika setiap kombinasi menghasilkan URL sendiri, beberapa halaman utama saja dapat berkembang menjadi ratusan atau bahkan ribuan variasi alamat.
Google menjelaskan bahwa navigasi berbasis filter dapat menciptakan ruang URL yang sangat besar sehingga crawler terus menemukan kombinasi URL baru yang sebenarnya tidak dibutuhkan untuk Search.
Masalahnya bukan semata-mata jumlah URL. Persoalan muncul ketika crawler harus mengalokasikan waktu pada variasi yang tidak memberikan informasi baru.
Apa Jenis URL Website Game yang Perlu Diaudit?
URL yang perlu diaudit adalah URL yang dapat dirayapi tetapi tidak mempunyai konten, fungsi pencarian, atau search intent yang cukup berbeda dari halaman utamanya.
Beberapa contoh yang patut diperiksa antara lain:
- URL sorting seperti
?sort=new - Filter yang menghasilkan halaman identik
- Parameter tracking
- Session ID
- Internal search result
- Tag atau archive yang sangat tipis
- Duplikat kategori
- URL lama yang sudah tidak digunakan
- Kombinasi filter tanpa permintaan pencarian
- Redirect URL yang masih banyak ditautkan secara internal
Tidak semua parameter harus dihapus atau diblokir.
Jika suatu filter mempunyai search demand, konten yang berbeda, dan fungsi landing page yang jelas, URL tersebut dapat tetap memiliki nilai SEO.
Kuncinya adalah membedakan halaman yang mempunyai tujuan pencarian dengan URL yang hanya tercipta akibat mekanisme sistem.
Bagaimana Cara Mengetahui Crawl Budget Website Mulai Bermasalah?
Crawl budget perlu diperiksa ketika Googlebot banyak mengakses URL bernilai rendah sementara halaman penting justru lambat ditemukan atau diperbarui.
Google menjelaskan bahwa pembahasan crawl budget tingkat lanjut terutama relevan bagi website dengan lebih dari sekitar satu juta halaman yang berubah secara rutin, situs 10.000+ halaman yang berubah setiap hari, atau website yang mempunyai banyak URL berstatus Discovered – currently not indexed.
Angka tersebut bukan batas pasti.
Website yang lebih kecil juga dapat mengalami crawl inefficiency apabila CMS atau sistem navigasinya menciptakan terlalu banyak variasi URL.
Karena itu, jangan hanya menghitung jumlah artikel yang terlihat di WordPress atau menu website.
Periksa seluruh URL yang dapat ditemukan crawler, termasuk parameter, taxonomy, pagination, archive, tag, hasil pencarian, attachment, AMP, dan endpoint lain.
Bagaimana Cara Membaca Gejala Overcrawling?
Overcrawling dapat dicurigai ketika terlalu banyak request Googlebot diarahkan ke URL parameter, redirect, soft 404, atau halaman duplikat dibanding URL utama.
Mulailah dengan melihat Crawl Stats di Google Search Console untuk memahami pola aktivitas Googlebot.
Selanjutnya, analisis server access log jika Anda membutuhkan data yang lebih rinci mengenai URL yang sebenarnya diminta crawler.
Bandingkan aktivitas tersebut dengan halaman yang menjadi prioritas bisnis.
Jika Googlebot terus mengunjungi URL rendah nilai sementara landing page, artikel baru, atau kategori penting lebih lambat diperbarui, struktur crawling perlu dievaluasi.
Jangan langsung menyimpulkan bahwa semua masalah indexing berasal dari crawl budget. Kualitas konten, canonicalization, internal linking, robots directive, server, dan status HTTP juga perlu diperiksa.
Bagaimana Cara Meningkatkan Crawl Efficiency Website Game?
Crawl efficiency dapat ditingkatkan dengan mengendalikan inventaris URL, mengurangi duplikasi, membersihkan internal link, menggunakan sitemap secara tepat, memperbaiki status HTTP, dan menjaga server tetap responsif.
Google menyebut known URL inventory sebagai salah satu faktor crawl demand yang paling dapat dikendalikan pemilik website.
Langkah pertama bukan memblokir semuanya.
Petakan terlebih dahulu halaman mana yang mempunyai fungsi jelas bagi pengguna dan mesin pencari.
Kategori utama, provider yang mempunyai search intent, panduan permainan, artikel informasi, atau landing page tertentu dapat tetap tersedia untuk crawling jika menawarkan informasi unik.
Sebaliknya, variasi URL yang hanya mengubah urutan tampilan biasanya tidak memerlukan perlakuan yang sama seperti halaman organik utama.
Bagaimana Robots.txt Membantu Mengendalikan Crawling?
Robots.txt dapat digunakan untuk mencegah crawler meminta kelompok URL tertentu yang memang tidak perlu dirayapi.
Ini berguna ketika website menghasilkan pola URL yang tidak memiliki fungsi bagi Search, misalnya sebagian variasi filter atau sorting.
Namun, penerapannya harus dilakukan setelah struktur URL dipahami.
Jangan memblokir CSS, JavaScript, gambar penting, atau resource yang diperlukan Google untuk memahami dan merender halaman tanpa alasan yang jelas.
Perlu dipahami juga bahwa robots.txt mengendalikan crawling, bukan merupakan cara yang sama dengan noindex.
Jika tujuan Anda adalah menghapus halaman dari indeks, gunakan directive indexing yang sesuai dan pastikan Googlebot masih dapat mengakses halaman tersebut untuk membaca directive.
Bagaimana Canonical Mengurangi Masalah URL Duplikat?
Canonical membantu Google memahami URL mana yang menjadi versi representatif ketika beberapa alamat menampilkan konten sama atau sangat mirip.
Contohnya, halaman berikut dapat menampilkan isi hampir identik:
/provider/pragmatic/
/provider/pragmatic/?sort=new
/provider/pragmatic/?utm_source=campaign
Daripada memperlakukan semuanya sebagai halaman utama yang berbeda, sinyal canonical dapat membantu mengarahkan konsolidasi ke URL yang diprioritaskan.
Google menjelaskan bahwa redirect dan rel="canonical" merupakan sinyal canonical yang kuat, sedangkan pencantuman dalam sitemap merupakan sinyal yang lebih lemah. Sinyal-sinyal tersebut dapat digunakan secara konsisten untuk memperkuat preferensi URL.
Namun, canonical bukan instruksi mutlak.
Google tetap dapat memilih URL lain jika sistem menilai halaman tersebut lebih representatif atau menemukan sinyal yang saling bertentangan.
Karena itu, gunakan canonical bersama internal link, sitemap, redirect, HTTPS, dan struktur URL yang konsisten.
Bagaimana Sitemap Membantu Googlebot Menemukan Halaman Penting?
Sitemap membantu Google menemukan URL yang ingin Anda prioritaskan untuk crawling dan pencarian, terutama halaman baru atau halaman yang diperbarui.
Sitemap bukan tempat untuk memasukkan seluruh URL yang dapat dihasilkan oleh CMS.
Prioritaskan URL canonical yang memang ingin ditampilkan pada hasil pencarian.
Google merekomendasikan penggunaan URL absolut dan menyarankan pemilik situs memasukkan URL yang ingin muncul di hasil pencarian.
Jika konten benar-benar berubah, gunakan <lastmod> secara akurat agar tanggal memberikan sinyal yang bermanfaat.
Jangan mengubah tanggal hanya untuk membuat halaman terlihat baru jika tidak ada perubahan substansial pada kontennya.
Satu file sitemap dapat menampung maksimal 50.000 URL atau 50 MB dalam kondisi tidak terkompresi. Website yang lebih besar dapat menggunakan beberapa sitemap dan menggabungkannya melalui sitemap index.
Mengapa Mengirim Sitemap Berulang Kali Tidak Mempercepat Indexing?
Sitemap membantu discovery, tetapi tidak memaksa Google untuk langsung merayapi atau mengindeks seluruh URL yang tercantum di dalamnya.
Melakukan submit sitemap yang sama berkali-kali bukan pengganti perbaikan technical SEO.
Jika halaman sulit ditemukan atau tidak diindeks, periksa internal linking, canonical, robots directive, status HTTP, kualitas konten, dan respons server.
Gunakan sitemap untuk memberikan struktur yang bersih dan konsisten, bukan sebagai tombol untuk memaksa indexing.
Untuk URL yang benar-benar penting setelah perubahan besar, URL Inspection dapat digunakan secara selektif.
Google sendiri mengingatkan bahwa fitur Request Indexing memiliki kuota sehingga lebih tepat digunakan untuk halaman prioritas.
Bagaimana Kecepatan Server Mempengaruhi Googlebot Crawling?
Server yang sehat dan responsif dapat membantu Googlebot melakukan crawling dengan lebih efisien karena Google menyesuaikan aktivitas crawler agar tidak membebani website.
Google menggunakan crawl capacity limit untuk menentukan seberapa besar aktivitas crawling yang dapat diterima sebuah host.
Jika latency dan waktu respons server stabil atau membaik, kapasitas crawling dapat meningkat.
Sebaliknya, error 5xx, respons server yang lambat, atau pembatasan kapasitas seperti HTTP 429 dapat membuat Google mengurangi crawling.
Karena itu, technical SEO sebaiknya tidak hanya fokus pada URL.
Periksa pula TTFB, hosting, cache, redirect chain, error server, dan resource halaman yang terlalu berat.
Bagaimana Core Web Vitals Berhubungan dengan Crawl Budget?
Core Web Vitals dan crawl budget merupakan dua konsep yang berbeda, tetapi optimasi performa website tetap dapat mendukung lingkungan crawling yang lebih sehat.
Core Web Vitals mengukur pengalaman pengguna melalui metrik performa halaman.
Crawl budget membahas bagaimana Google mengalokasikan resource untuk mengunjungi URL.
Jadi, memperbaiki Core Web Vitals tidak otomatis menaikkan crawl budget.
Namun, server dan halaman yang cepat diakses serta dirender dapat membantu Google menggunakan resource crawling secara lebih efisien.
Karena itu, pada Core Web Vitals website game, optimasi sebaiknya berjalan bersama perbaikan server, pengurangan resource berat, dan pembersihan inventaris URL.
Bagaimana AMP dan Canonical Harus Diatur agar Tidak Membingungkan Google?
Halaman AMP perlu mempunyai hubungan yang jelas dengan canonical agar Google memahami bahwa keduanya merupakan versi dari konten yang sama.
Jika terdapat halaman canonical non-AMP dan versi AMP, halaman canonical perlu memberikan hubungan menuju AMP, sedangkan halaman AMP perlu menunjuk kembali ke canonical yang benar.
Google masih mendokumentasikan penggunaan rel="amphtml" pada halaman canonical dan rel="canonical" pada halaman AMP.
Konten utama serta tindakan penting bagi pengguna juga sebaiknya tersedia secara konsisten pada kedua versi.
Misalnya, apabila slotgilanaga.com berfungsi sebagai landing page canonical dan login.slotgilanaga.com memang merupakan versi AMP dari konten yang sama, hubungan keduanya harus dibuat secara teknis dengan benar.
Namun, jika kedua halaman mempunyai fungsi atau konten yang berbeda, jangan memaksakan hubungan AMP-canonical hanya karena berada dalam satu brand.
Siapa Solusi Terbaik untuk Audit Crawl Budget Website Game?
jasaseojuara.com dapat membantu mengevaluasi struktur URL, crawl efficiency, sitemap, canonical, internal linking, performa server, dan masalah technical SEO yang membuat crawler menghabiskan resource pada URL yang tidak strategis.
Halo Sahabat jasaseojuara.com, masalah crawling sering kali tidak terlihat hanya dengan membuka halaman website.
Akar persoalannya dapat berada pada CMS, taxonomy, filter, plugin, parameter URL, redirect, sitemap, atau hubungan internal link.
Karena itu, audit sebaiknya dimulai dengan memetakan URL yang benar-benar dibutuhkan pengguna dan URL yang dapat ditemukan Googlebot.
Dari sana, setiap URL dapat dikelompokkan menjadi halaman yang dipertahankan, dikonsolidasikan, diarahkan, diperbaiki, atau dibatasi crawling-nya.
Pendekatan tersebut jauh lebih efektif daripada sekadar mengejar jumlah halaman terindeks.
Untuk website di Medan maupun proyek digital dengan target pasar lebih luas, jasaseojuara dapat menggabungkan technical SEO dengan evaluasi struktur konten dan internal linking.
Sebagai ilustrasi, brand visual seperti Fantasy Landscape tidak harus menghasilkan landing page baru untuk setiap kombinasi filter gambar.
Satu halaman yang kuat, relevan, dan mempunyai search intent jelas sering lebih efisien daripada puluhan URL tipis yang hanya berbeda parameter.
Prinsip serupa berlaku pada website game.
Struktur yang terorganisasi membantu pengguna sekaligus membuat jalur crawling lebih mudah dipahami.
Konten pendukung publik juga dapat diarahkan melalui tyler-hall.com jika halaman tersebut memang relevan secara topikal.
Hindari menjadikan /wp-admin sebagai tujuan backlink SEO karena halaman administrasi WordPress tidak dirancang sebagai landing page publik bagi pengguna maupun mesin pencari.
Apa Pain Points Crawl Budget yang Paling Sering Terjadi?
Masalah crawl budget paling sering muncul ketika jumlah URL yang ditemukan crawler jauh lebih besar daripada jumlah halaman bernilai yang ingin diprioritaskan website.
Apa yang Harus Dilakukan Jika Ribuan URL Parameter Dirayapi?
Cari sumber yang membuat Google menemukan parameter tersebut.
Periksa filter, internal link, sitemap, JavaScript, dan pola navigasi sebelum menentukan apakah URL perlu dikonsolidasikan, diblokir dari crawl, atau dipertahankan.
Mengapa Artikel Baru Lambat Ditemukan Google?
Pastikan artikel mempunyai internal link crawlable, termasuk dalam sitemap yang tepat, menggunakan canonical yang benar, tidak terkena directive yang salah, dan memberikan respons HTTP normal.
Kualitas serta hubungan artikel dengan struktur website juga perlu diperiksa.
Apa yang Harus Dilakukan Jika Banyak Soft 404?
Periksa halaman yang mengembalikan status 200 tetapi pada praktiknya tidak mempunyai konten yang bernilai atau menunjukkan bahwa resource sudah tidak tersedia.
Google secara khusus memasukkan perbaikan soft 404 sebagai salah satu praktik pengelolaan crawl budget.
Bagaimana jasaseojuara.com Dapat Membantu?
Audit technical SEO membantu menentukan URL mana yang perlu dipertahankan, dikonsolidasikan, diarahkan, diperbaiki, atau dikeluarkan dari jalur crawling utama.
Tujuannya adalah membangun arsitektur website yang lebih sederhana bagi pengguna dan crawler.
Apa FAQ Crawl Budget SEO yang Sering Ditanyakan?
Pertanyaan tentang crawl budget biasanya berhubungan dengan ukuran website, robots.txt, sitemap, canonical, indexing, dan aktivitas Googlebot.
Apa Crawl Budget Penting untuk Website Kecil?
Tidak selalu.
Google menyatakan bahwa website yang tidak mempunyai banyak halaman yang berubah cepat dan dapat melihat halaman baru dirayapi pada hari yang sama biasanya tidak perlu terlalu memikirkan crawl budget tingkat lanjut.
Apakah Sitemap Bisa Memaksa Googlebot Melakukan Crawling?
Tidak.
Sitemap membantu Google menemukan URL dan memahami halaman yang ingin Anda prioritaskan, tetapi tidak menjamin crawling maupun indexing.
Apakah Noindex Menghemat Crawl Budget?
Tidak secara langsung.
Googlebot perlu mengakses halaman agar dapat membaca directive noindex. Karena itu, noindex lebih tepat dipahami sebagai kontrol indexing, bukan kontrol crawling.
Apakah Canonical Menghentikan Googlebot Mengunjungi URL Duplikat?
Tidak secara langsung.
Canonical membantu Google mengelompokkan serta memilih URL representatif. Setelah Google memahami hubungan tersebut, halaman duplikat umumnya dapat dirayapi lebih jarang dibanding canonical.
Apa Kesimpulan Terpenting tentang Crawl Budget Website Game?
Crawl budget yang sehat berasal dari arsitektur URL yang terkendali, performa server yang baik, dan kemampuan Google memahami halaman mana yang benar-benar penting.
Poin utama yang perlu diterapkan:
- Audit seluruh URL yang dapat ditemukan Googlebot.
- Bedakan halaman bernilai dengan variasi URL yang dibuat sistem.
- Kurangi filter dan parameter yang tidak mempunyai search intent.
- Gunakan canonical secara konsisten pada halaman duplikat atau sangat mirip.
- Arahkan internal link ke URL canonical.
- Masukkan halaman yang ingin tampil di Google ke sitemap.
- Gunakan
<lastmod>hanya ketika konten benar-benar berubah. - Gunakan robots.txt untuk mengendalikan crawling bila memang diperlukan.
- Jangan menganggap
noindexsebagai pengganti robots.txt. - Perbaiki soft 404 dan redirect chain yang tidak diperlukan.
- Pantau error
5xx, HTTP429, dan performa server. - Analisis Crawl Stats serta server log untuk memahami perilaku crawler.
- Prioritaskan halaman yang mempunyai search intent dan nilai nyata bagi pengguna.
Panduan teknis resmi dapat dipelajari melalui Google Crawling Infrastructure – Optimize Crawl Budget.
Bagaimana Memulai Audit Crawl Budget Bersama jasaseojuara.com?
Mulailah dengan membandingkan jumlah URL yang ingin Anda rankingkan dengan seluruh URL yang saat ini dapat ditemukan Googlebot.
Jika website hanya mempunyai ratusan halaman bernilai tetapi sistem menghasilkan ribuan atau puluhan ribu URL tambahan, bagian tersebut layak menjadi prioritas audit.
Sahabat jasaseojuara.com dapat memulai dari Crawl Stats, sitemap, Page Indexing, canonical, internal linking, robots.txt, status HTTP, serta struktur parameter.
Dari hasil tersebut, jasaseojuara.com dapat membantu menyusun prioritas perbaikan technical SEO tanpa menghilangkan halaman yang masih mempunyai search intent.
Target akhirnya bukan sekadar memperoleh lebih banyak aktivitas Googlebot.
Target yang lebih penting adalah membuat jalur crawling lebih efisien sehingga Google lebih mudah menemukan, memahami, dan memperbarui halaman yang benar-benar penting bagi pengguna serta pertumbuhan traffic organik website.