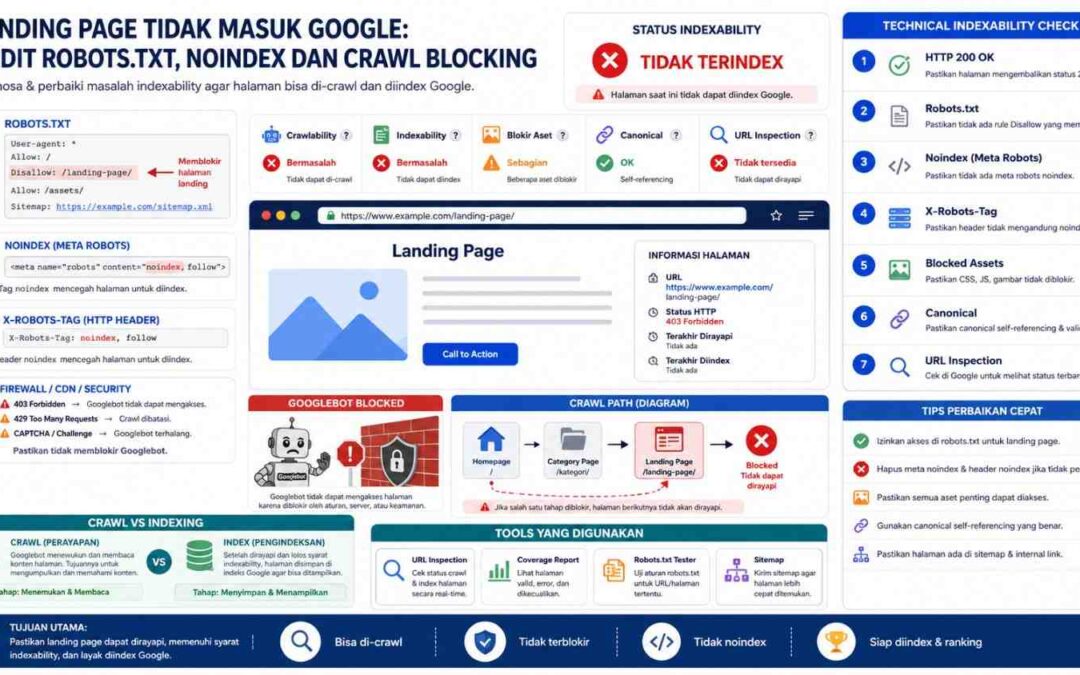
Landing Page Tidak Masuk Google Audit Robots.txt, Noindex dan Crawl Blocking
Landing page tidak terindex noindex robots merupakan salah satu kelompok masalah technical SEO yang perlu diperiksa lebih dahulu sebelum melakukan Request Indexing, menambah sitemap, atau membangun backlink.
Sebuah landing page dapat mempunyai desain yang bagus, konten lengkap, canonical benar, dan bahkan tercantum di sitemap. Namun, jika Googlebot tidak dapat mengakses halaman atau mendapatkan instruksi noindex, URL tersebut tetap dapat bermasalah dalam proses crawling dan indexing.
Masalahnya, crawling dan indexing bukan proses yang sama.
Google menjelaskan bahwa robots.txt digunakan untuk mengontrol apakah crawler dapat melakukan request terhadap sebuah URL. Sementara itu, jika pemilik website ingin halaman tidak dimasukkan ke Google Search, mekanisme yang sesuai adalah noindex. Google juga menegaskan bahwa memblokir Googlebot melalui robots.txt tidak selalu mencegah URL muncul di Search, karena URL masih dapat ditemukan melalui link dari halaman lain.
Karena itu, workflow diagnosis yang benar adalah:
HTTP Access → Authentication → Firewall/CDN → Robots.txt → Meta Robots → X-Robots-Tag → Resource Access → Rendering → Canonical → URL Inspection
Artikel ini membahas setiap lapisan tersebut secara teknis agar Anda dapat mengetahui apakah masalah landing page berada pada crawl blocking, indexability, atau lapisan lain.
Crawling dan Indexing Jangan Disamakan
Sebelum memeriksa robots.txt, pahami dua proses ini.
Crawling
Crawling adalah proses ketika Googlebot mengambil URL dan resource yang dibutuhkan untuk memahami halaman.
Secara sederhana:
Google menemukan URL
        ↓
Googlebot melakukan request
        ↓
Server memberikan response
        ↓
Google memperoleh HTML/resource
Robots.txt terutama bekerja pada tahap ini.
Google mendeskripsikan robots.txt sebagai file yang memberi tahu crawler bagian mana dari sebuah situs yang dapat atau tidak dapat diminta.
Indexing
Setelah Google memperoleh halaman, konten kemudian dapat diproses untuk indexing.
Google dapat melihat:
- teks;
- title;
- canonical;
- robots directives;
- link;
- rendered content;
- structured information;
- duplicate relationship.
Karena itu:
crawl allowed ≠ pasti indexed
dan:
crawl blocked ≠ URL pasti hilang dari Search
Perbedaan terakhir ini sangat penting.
Google secara eksplisit menjelaskan bahwa URL yang diblokir robots.txt masih dapat ditemukan dan diindex sebagai URL apabila Google menemukannya melalui link lain. Dalam kasus tersebut, Google mungkin tidak mempunyai konten halaman untuk ditampilkan, tetapi URL-nya tetap dapat muncul.
Untuk workflow indexing yang lebih luas, artikel ini sebaiknya terhubung ke #10 – cara indexing landing page Google.
1. Audit Robots.txt Landing Page
Mulai dengan membuka:
https://example.com/robots.txt
Robots.txt yang valid harus berada pada root host. Google menjelaskan bahwa file pada subdirectory bukan robots.txt yang berlaku untuk host tersebut.
Contoh sederhana:
User-agent: *
Allow: /
Artinya crawler secara umum diperbolehkan mengakses website.
Namun masalah dapat muncul dengan rule seperti:
User-agent: *
Disallow: /landing/
Jika URL target adalah:
https://example.com/landing/seo-amp/
Googlebot tidak diperbolehkan melakukan crawling terhadap URL tersebut.
Audit Developer
Periksa:
User-agent;Disallow;Allow;- wildcard;
- folder AMP;
- parameter URL;
- staging rule lama;
- perbedaan host/subdomain.
Jangan hanya mencari:
Disallow: /
Rule yang lebih sempit juga bisa mengenai landing page secara tidak sengaja.
2. Kesalahan Robots.txt pada AMP
Misalnya semua AMP ditempatkan di:
/amp/
kemudian robots.txt berisi:
User-agent: *
Disallow: /amp/
Landing page:
https://example.com/amp/landing-page/
akhirnya terblokir.
Halaman tersebut dapat:
- valid AMP;
- memberikan HTTP 200;
- mempunyai canonical;
- masuk sitemap;
tetapi crawler tetap tidak dapat mengambil URL akibat robots rule.
Inilah mengapa AMP indexing error tidak selalu berasal dari AMP markup.
Kadang masalahnya jauh lebih dasar: crawler memang tidak diberi akses.
Untuk pembahasan AMP validation serta indexing lebih detail, hubungkan artikel ini ke #6 menggunakan anchor AMP indexing technical audit.
3. Jangan Pakai Robots.txt untuk Menghapus Landing Page dari Google
Ini salah satu kesalahan paling berbahaya.
Misalnya seseorang ingin menghapus:
https://example.com/page-lama/
Kemudian memasang:
User-agent: *
Disallow: /page-lama/
Tujuannya:
Jangan tampilkan URL ini lagi di Search.
Masalahnya, robots.txt bukan mekanisme yang tepat untuk tujuan tersebut.
Google secara eksplisit menjelaskan bahwa halaman yang diblokir robots.txt masih dapat diindex berdasarkan informasi eksternal jika ditemukan melalui link lain. Google juga menyatakan robots.txt bukan mekanisme untuk menjaga halaman agar tidak masuk Google.
Jika tujuannya mencegah halaman muncul di Search, gunakan metode yang sesuai, misalnya:
<meta name="robots" content="noindex">
atau password protection apabila kontennya memang private.
4. Periksa Meta Robots Noindex
Setelah memastikan crawling diizinkan, buka source HTML landing page.
Cari:
<meta name="robots" content="noindex">
atau:
<meta name="googlebot" content="noindex">
Jika tersedia, halaman sedang meminta Google agar tidak memasukkannya ke index.
Google menjelaskan bahwa noindex dapat digunakan untuk mencegah sebuah halaman muncul pada hasil Google Search.
Contoh halaman yang ingin diindex
Anda bahkan tidak wajib menambahkan:
<meta name="robots" content="index,follow">
karena perilaku default adalah index, follow. Google menyatakan nilai default tersebut tidak perlu dideklarasikan.
Jadi:
<head>
  <title>Technical SEO Landing Page</title>
</head>
secara default tidak membutuhkan tag:
<meta name="robots" content="index,follow">
kecuali ada kebutuhan khusus.
5. Periksa Meta Robots yang Bertentangan
Kadang terdapat beberapa tag sekaligus.
Contoh:
<meta name="robots" content="index,follow">

<meta name="googlebot" content="noindex">
Dalam kasus aturan bertentangan, Google menerapkan aturan yang lebih restrictive.
Masalah seperti ini dapat muncul akibat:
- plugin SEO;
- theme;
- custom code;
- environment staging;
- header injection;
- cache lama.
Karena itu, jangan hanya melihat pilihan:
“Allow search engines”
di CMS.
Periksa source HTML final yang benar-benar diterima browser.
6. Robots.txt + Noindex Bersamaan Bisa Menjadi Kesalahan
Pertimbangkan konfigurasi:
robots.txt:

User-agent: *
Disallow: /private-page/
dan halaman tersebut mempunyai:
<meta name="robots" content="noindex">
Sekilas terlihat lebih kuat:
Diblock + noindex sekaligus.
Namun justru ada masalah.
Agar Google dapat membaca noindex, crawler harus dapat mengakses halaman.
Google secara eksplisit menjelaskan bahwa jika halaman diblokir robots.txt, crawler tidak dapat melihat aturan noindex. Akibatnya URL masih dapat muncul di Search apabila ditemukan dari sumber lain.
Jadi jika tujuannya:
biarkan Google crawl, tetapi jangan index
gunakan:
robots.txt:
ALLOW
kemudian:
<meta name="robots" content="noindex">
Bukan memblokir kedua jalurnya sekaligus.
7. Audit X-Robots-Tag pada HTTP Header
Tidak semua noindex berada di HTML.
Server dapat mengirim:
HTTP/1.1 200 OK
X-Robots-Tag: noindex
Ini disebut X-Robots-Tag.
Google mendukung penggunaan X-Robots-Tag pada response header untuk memberikan indexing directives.
Masalahnya, tag ini tidak terlihat ketika Anda hanya membuka:
View Source
Karena itu cek response header melalui:
- Chrome DevTools → Network;
- server tools;
curl.
Contoh:
curl -I https://example.com/landing-page/
Kemudian cari:
X-Robots-Tag
Jika hasilnya:
X-Robots-Tag: noindex
halaman sedang diblokir dari indexing di level server.
8. X-Robots-Tag Sering Berasal dari Konfigurasi Server
Developer terkadang tidak pernah memasukkan noindex dalam HTML.
Namun server atau CDN dapat menambahkannya.
Contoh sumber:
.htaccess;- Apache config;
- Nginx;
- CDN rule;
- hosting panel;
- security plugin;
- reverse proxy;
- staging environment.
Contoh Apache:
Header set X-Robots-Tag "noindex"
Jika directive diterapkan pada folder yang terlalu luas, seluruh landing page di bawah folder tersebut dapat terkena.
Karena itu, audit indexability perlu mengecek:
HTML + HTTP response
bukan hanya WordPress SEO settings.
9. Authentication Dapat Menghalangi Googlebot
Bayangkan landing page memberikan halaman login sebelum pengguna dapat melihat konten.
Misalnya:
Landing Page
     ↓
Authentication
     ↓
Username + Password
Jika Googlebot tidak dapat melewati authentication tersebut, crawler tidak mendapatkan konten yang ingin Anda index.
Google merekomendasikan password protection ketika konten memang harus private dan tidak ingin tersedia bagi crawler maupun Search.
Namun untuk landing page public yang memang ingin memperoleh organic visibility, pastikan Googlebot tidak diwajibkan:
- login;
- memasukkan OTP;
- menyelesaikan challenge;
- menerima session tertentu;
- melewati access gateway.
Gunakan authentication hanya pada bagian yang memang tidak ditujukan untuk Search.
10. Firewall dan CDN Dapat Memblokir Googlebot
Ini salah satu masalah yang sering tidak terlihat di WordPress atau AMP Validator.
Website menggunakan:
Firewall
↓
CDN
↓
Bot Protection
↓
Origin Server
Browser Anda memperoleh halaman dengan normal.
Namun Googlebot mungkin terkena:
403 Forbidden
429 Too Many Requests
Challenge Page
CAPTCHA
Connection failure
Akibatnya:
User → halaman normal
tetapi:
Googlebot → blocked
Jika itu terjadi, masalah tidak berada pada keyword, sitemap, atau canonical.
Masalahnya adalah crawl accessibility.
Google memberikan panduan khusus untuk mengidentifikasi crawler Google dan memperingatkan bahwa akses Googlebot dapat dipengaruhi oleh konfigurasi keamanan.
Audit:
- bot protection;
- rate limiting;
- IP blocking;
- firewall rules;
- geo-blocking;
- reverse proxy;
- CDN challenge.
11. Jangan Whitelist “Googlebot” Hanya Berdasarkan User-Agent
User-Agent dapat dipalsukan.
Karena itu, jika melakukan security diagnosis, jangan otomatis mengizinkan request hanya karena string menunjukkan:
Googlebot
Gunakan metode verifikasi crawler yang sesuai dengan dokumentasi Google.
Tujuannya adalah menjaga security tetap aktif sambil memastikan crawler Google asli tidak diblokir secara tidak sengaja.
12. Audit Blocked JavaScript dan CSS
Google tidak hanya membutuhkan HTML.
Untuk banyak halaman modern, rendering juga membutuhkan JavaScript dan CSS.
Google menjelaskan pemrosesan JavaScript dilakukan melalui:
crawling → rendering → indexing.
Google juga menjelaskan bahwa rendering mengambil dan menjalankan JavaScript serta CSS untuk memahami kondisi visual dan textual akhir sebuah halaman.
Karena itu, konfigurasi:
User-agent: *
Disallow: /assets/
dapat menjadi masalah jika folder tersebut berisi:
/assets/app.js
/assets/main.css
yang diperlukan untuk menampilkan main content.
Google telah lama menyarankan agar resource JavaScript dan CSS yang diperlukan tidak diblokir karena crawler perlu melihat halaman seperti pengguna.
Contoh Robots.txt Resource Blocking
Bermasalah
User-agent: *
Disallow: /includes/
padahal:
/includes/main.js
/includes/style.css
dibutuhkan untuk rendering.
Lebih terarah
User-agent: *
Disallow: /includes/

User-agent: Googlebot
Allow: /includes/
Dokumentasi robots Google bahkan memberikan pola sejenis untuk menjelaskan bagaimana JavaScript dan CSS dapat diizinkan bagi Googlebot saat resource tersebut dibutuhkan untuk rendering.
Namun jangan menyalin konfigurasi ini secara buta.
Sesuaikan dengan struktur situs Anda.
13. AMP Indexing Error karena Blocked Assets
Landing page AMP biasanya lebih ketat dari sisi markup, tetapi tetap bisa menggunakan berbagai resource.
Audit:
- AMP runtime;
- fonts;
- images;
- JSON endpoint;
- iframe;
- custom data;
- consent components.
Jika resource penting gagal dimuat akibat CDN atau security configuration, hasil rendering dapat berbeda.
Karena itu, setelah robots dan noindex diperiksa, jalankan:
Google Search Console → URL Inspection → Test Live URL
Kemudian lihat bagaimana Google memahami halaman terbaru.
Bagian ini dapat dihubungkan ke #8 – URL Inspection landing page menggunakan anchor Test Live URL Google Search Console.
14. Canonical Bisa Membuat Halaman Terlihat seperti Masalah Indexing
Landing page:
https://example.com/page/
memiliki:
<link
  rel="canonical"
  href="https://example.com/page-lama/">
Halaman /page/ sebenarnya crawlable dan tidak memakai noindex.
Namun website sendiri menunjukkan:
/page-lama/adalah versi representatif.
Akibatnya /page/ mungkin tidak menjadi URL yang dipertahankan sebagai canonical.
Karena itu, setelah robots/noindex dinyatakan aman, periksa canonical.
Google secara khusus memperingatkan agar robots.txt tidak digunakan untuk canonicalization, karena URL yang diblokir crawling masih dapat diindex tanpa kontennya.
Untuk diagnosis canonical lebih dalam, hubungkan ke #2 – canonical AMP landing page.
15. Contoh Diagnosis Landing Page NAGAVIP
Prinsip audit yang sama dapat diterapkan pada landing page eksternal.
Sebagai contoh, NAGAVIP dapat dianalisis dengan memisahkan pertanyaan accessibility dari indexing.
URL tersebut aktif ketika diperiksa untuk penyusunan artikel ini.
Namun browser accessibility saja tidak cukup untuk memastikan bagaimana crawler memproses landing page NAGAVIP.
Untuk technical audit, perlu diperiksa:
HTTP status
↓
robots.txt
↓
meta robots
↓
X-Robots-Tag
↓
firewall/CDN
↓
resource rendering
↓
canonical
↓
Google Search Console
Dengan demikian, external link menuju situs NAGAVIP menjadi contextual reference, bukan pengganti technical indexability audit.
16. Decision Tree: Landing Page Tidak Terindex
Gunakan alur berikut:
LANDING PAGE TIDAK TERINDEX
│
├── URL bisa diakses?
│     │
│     ├── TIDAK
│     │     └── Audit server / authentication / firewall / CDN
│     │
│     └── YA
│
├── HTTP 200?
│     │
│     ├── TIDAK → perbaiki status / redirect
│     └── YA
│
├── Diblok robots.txt?
│     │
│     ├── YA → buka crawling jika halaman ingin dicrawl
│     └── TIDAK
│
├── Meta robots noindex?
│     │
│     ├── YA → hapus jika tidak disengaja
│     └── TIDAK
│
├── X-Robots-Tag noindex?
│     │
│     ├── YA → perbaiki server/CDN rule
│     └── TIDAK
│
├── Resource penting terblokir?
│     │
│     ├── YA → buka CSS/JS/API penting
│     └── TIDAK
│
├── Rendered content lengkap?
│     │
│     ├── TIDAK → audit JS/rendering
│     └── YA
│
├── Canonical benar?
│     │
│     ├── TIDAK → perbaiki canonical
│     └── YA
│
└── Live Test
       ↓
   Request Indexing
       ↓
   Monitoring
17. Cara Mengetahui Googlebot Benar-Benar Blocked
Jangan hanya mengandalkan browser pribadi.
Gunakan beberapa sumber data:
URL Inspection
Lakukan Test Live URL.
Server Logs
Cari request crawler dan status response.
Contoh:
Googlebot → /landing-page/
HTTP → 403
Ini sinyal kuat bahwa lapisan security perlu diperiksa.
CDN Logs
Jika menggunakan CDN, lihat:
- blocked requests;
- bot classifications;
- rate limit;
- firewall events.
Browser/HTTP Headers
Periksa status response dan X-Robots-Tag.
Dengan menggabungkan beberapa sumber data, diagnosis menjadi lebih akurat dibanding sekadar melakukan submit sitemap berulang kali.
18. Periksa Page Availability sebelum Request Indexing
Jika Googlebot tidak dapat mengambil halaman, Request Indexing bukan solusi.
Urutan yang lebih tepat:
Technical Fix
↓
Live Test
↓
Pastikan Google dapat fetch
↓
Request Indexing
Google sendiri dalam berbagai dokumentasi menyarankan memastikan halaman dapat diakses Google serta tidak diblokir robots.txt, noindex, atau login requirement sebelum meminta crawl ulang.
Jadi Request Indexing berada di akhir diagnosis.
Bukan langkah pertama.
19. Jangan Menganggap Semua “Blocked” sebagai Error
Ada halaman yang memang seharusnya diblokir.
Contoh:
- wp-admin;
- internal search;
- private dashboard;
- customer account;
- checkout tertentu;
- staging environment;
- API endpoint;
- duplicate parameter.
Technical SEO yang baik bukan berarti Googlebot harus dapat crawl semua URL.
Tujuannya:
halaman yang ingin muncul di Search → crawlable dan indexable
sementara:
halaman private/tidak berguna untuk Search → dikontrol dengan metode yang tepat.
Pemilihan metode tersebut bergantung tujuan.
20. Metode yang Tepat Berdasarkan Tujuan
Ingin Google Tidak Crawl?
Gunakan:
robots.txt
Google memang mendokumentasikan robots.txt sebagai mekanisme untuk membatasi crawling.
Ingin Google Crawl tetapi Tidak Index?
Gunakan:
<meta name="robots" content="noindex">
atau:
X-Robots-Tag: noindex
dan pastikan crawler tetap dapat mengakses resource tersebut agar directive dapat dibaca.
Ingin Konten Benar-Benar Private?
Gunakan:
Authentication / Password Protection
Google merekomendasikan password protection untuk konten confidential/private.
Ingin Menggabungkan Duplicate URL?
Gunakan:
rel="canonical"
atau redirect sesuai kebutuhan.
Jangan menggunakan robots.txt sebagai canonicalization method.
Checklist Technical Indexability Landing Page
Server & Access
- HTTP status target adalah 200.
- Tidak membutuhkan login jika halaman ingin tampil di Search.
- Tidak terkena CAPTCHA untuk Googlebot.
- Firewall tidak memblokir crawler asli.
- CDN tidak menghasilkan 403/429.
- Rate limiting tidak terlalu agresif.
Robots.txt
- File tersedia pada root host.
- Landing page tidak terkena
Disallow. - Folder AMP tidak terblokir tanpa alasan.
- CSS penting dapat dicrawl.
- JavaScript penting dapat dicrawl.
- Robots.txt tidak digunakan untuk menghapus URL dari Search.
Meta Robots
- Tidak terdapat
noindexjika halaman ingin diindex. - Tidak ada
googlebot noindex. - Tidak terdapat directive yang saling bertentangan.
- Plugin SEO tidak menghasilkan noindex otomatis.
HTTP Headers
- Tidak ada
X-Robots-Tag: noindex. - Header CDN sudah diperiksa.
- Header server sudah diperiksa.
Rendering
- Main content terlihat pada rendered version.
- H1 tersedia.
- Internal link tersedia.
- CTA tidak menjadi satu-satunya content.
- JS/CSS utama tidak terblokir.
Canonical
- Canonical mengarah ke URL yang benar.
- Tidak canonical ke homepage.
- Tidak canonical ke URL lama.
- HTTP/HTTPS konsisten.
- AMP/non-AMP relationship benar.
Search Console
- URL Inspection sudah dijalankan.
- Page availability dicek.
- Live Test berhasil.
- Rendered resources diperiksa.
- User-declared canonical dicek.
- Google-selected canonical dicek.
- Request Indexing baru dilakukan setelah masalah selesai.
Internal Linking untuk Topic Cluster
Artikel ini harus terhubung dengan cluster berikut.
2 Canonical Architecture
Gunakan anchor:
canonical AMP landing page
pada bagian canonicalization.
6 AMP Indexing
Gunakan anchor:
AMP indexing error
pada bagian halaman AMP yang terblokir.
7 Indexing Workflow
Gunakan anchor:
cara indexing landing page Google
ketika membahas proses setelah technical issue selesai.
8 URL Inspection
Gunakan anchor:
URL Inspection landing page
pada bagian Live Test dan rendered resources.
10 Search Console Monitoring
Gunakan anchor:
Google Search Console indexing
pada tahap monitoring.
Sebaliknya, artikel tersebut sebaiknya memberikan internal link kembali menggunakan anchor seperti:
- landing page tidak terindex noindex robots;
- robots.txt SEO;
- Googlebot blocked;
- crawl blocking;
- technical indexability landing page.
FAQ Landing Page Tidak Terindex
Apa bedanya robots.txt dan noindex?
Robots.txt mengatur apakah crawler dapat melakukan request terhadap URL, sedangkan noindex meminta Google agar halaman tidak dimasukkan ke Search. Google secara eksplisit membedakan fungsi keduanya.
Apakah URL yang diblok robots.txt pasti hilang dari Google?
Tidak. Google menjelaskan URL yang diblokir robots.txt masih dapat ditemukan dan muncul di hasil Search apabila diketahui melalui link lain.
Mengapa noindex tidak bekerja?
Salah satu penyebabnya adalah halaman juga diblokir robots.txt. Jika crawler tidak dapat mengambil halaman, Google tidak dapat membaca noindex yang terdapat di dalamnya.
Apa itu X-Robots-Tag?
X-Robots-Tag merupakan robots directive yang dikirim melalui HTTP response header. Google mendukung X-Robots-Tag, termasuk penggunaan noindex.
Apakah firewall dapat menyebabkan landing page tidak terindex?
Bisa apabila firewall, CDN, rate limiting, atau bot protection mencegah Googlebot mengakses halaman atau resource yang diperlukan.
Apakah CSS dan JavaScript boleh diblokir?
Resource yang tidak diperlukan dapat dikontrol, tetapi JavaScript dan CSS yang diperlukan untuk memahami dan merender main content sebaiknya dapat diakses Google. Google menggunakan rendering untuk memahami JavaScript pages.
Apakah robots.txt dapat digunakan untuk canonical?
Tidak. Google secara eksplisit meminta agar robots.txt tidak digunakan sebagai canonicalization mechanism.
Haruskah saya Request Indexing setelah menghapus noindex?
Setelah memastikan masalah selesai, jalankan Live Test. Jika halaman dapat diakses dan indexability sudah benar, Request Indexing dapat digunakan untuk meminta crawl ulang pada URL penting.
Minta Technical Indexability Check
Jika sebuah landing page tidak muncul di Google, jangan langsung menyimpulkan masalahnya adalah backlink atau keyword.
Audit terlebih dahulu:
Server Access
↓
Authentication
↓
Firewall/CDN
↓
Robots.txt
↓
Meta Robots
↓
X-Robots-Tag
↓
Blocked Resources
↓
Rendering
↓
Canonical
↓
URL Inspection
Masalah kecil seperti:
Disallow: /amp/
atau:
<meta name="robots" content="noindex">
atau:
X-Robots-Tag: noindex
dapat membuat strategi indexing tidak bekerja seperti yang diharapkan.
Yang paling penting, jangan menggunakan robots.txt sebagai alat untuk menghapus halaman dari Search. Google menjelaskan bahwa URL yang tidak boleh dicrawl masih dapat ditemukan melalui link lain dan muncul sebagai URL dalam hasil pencarian.
Minta Technical Indexability Check untuk memeriksa apakah masalah landing page berada pada crawler access, robots directives, server/CDN, resource rendering, canonical, atau proses indexing berikutnya.